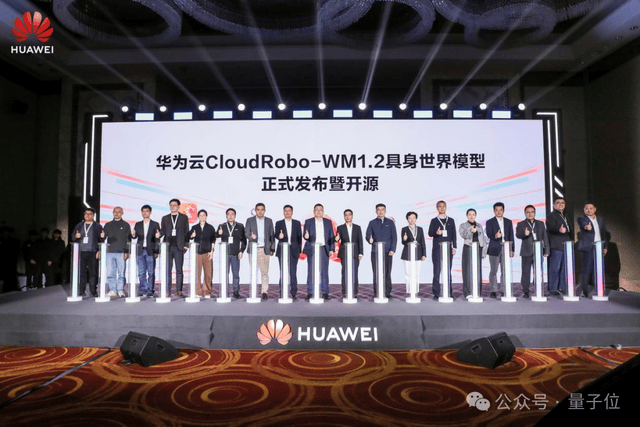
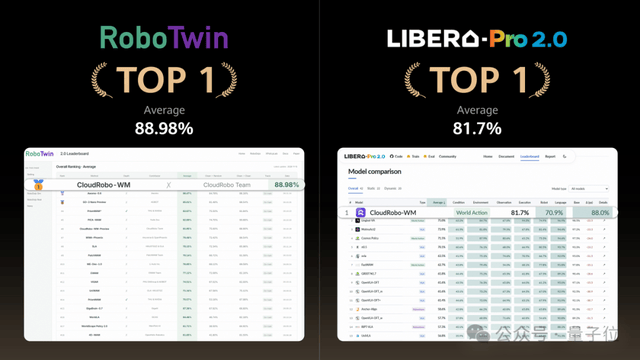
量子位报道,一个基于昇腾算力训练的具身世界模型在两项榜单上取得 SOTA,华为云方面表示将把整套底座开放出来。报道同时提出一个判断:国产算力的成熟,正把具身智能的竞争维度从「芯片有多强」转向训练效率、数据规模、部署成本与场景落地速度的多维比拼。
从单点算力到训练效率的比拼
具身世界模型要处理的是机器人与物理环境交互产生的多模态序列,训练侧对算力规模和集群稳定性的要求都高。此前讨论国产算力,焦点多落在单卡性能与制程差距上;这次报道给出的信号是,评价标准正在转向「用同样的算力能训出什么」。双榜 SOTA 的意义不在于刷新某个指标,而在于证明昇腾这条技术路线可以支撑具身世界模型这类前沿训练任务,从而让算力选型从「能不能用」进入「划不划算」的比较阶段。
世界模型为何成为具身智能的关键环节
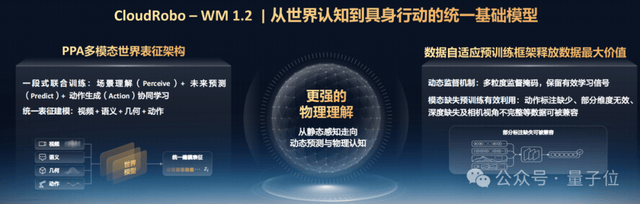
具身智能的落地瓶颈之一是真机数据昂贵、采集慢、覆盖场景有限。世界模型的思路是让模型学习环境动态,在虚拟空间中生成和预测交互结果,从而降低对真实数据的依赖,并支撑仿真训练与策略评估。这类模型对训练吞吐和数据管线要求高,天然依赖成规模的算力底座。若底座能力可被外部团队复用,中小具身团队不必自建大规模集群,就能把精力放在数据与场景上,这会改变行业的分工方式。
开放底座的现实考量
华为云提出开放整套底座,实际影响取决于开放的具体形态:是算力资源、训练框架与工具链,还是包含数据与评测在内的完整流程。对具身团队而言,迁移成本、框架兼容性和长期可用性比单次榜单成绩更重要。报道没有披露开放范围与时间表,因此现阶段更宜视为方向性表态。可以确定的是,国产算力若想在具身赛道站稳,需要的不只是一个跑分案例,而是可持续的开发者生态和可复现的训练路径。
对国内具身智能团队来说,多一条可用的国产训练底座意味着算力选型多一个选项,但能否真正降低成本,还要看开放后的工具链成熟度与实际迁移代价。
来源:量子位 查看原文 (本文基于公开信息整理改编)