推理模型刚出现时,一次复杂任务的成本让很多团队望而却步。现在同样的任务,成本已经降到可以日常使用的水平。
降价的三个来源
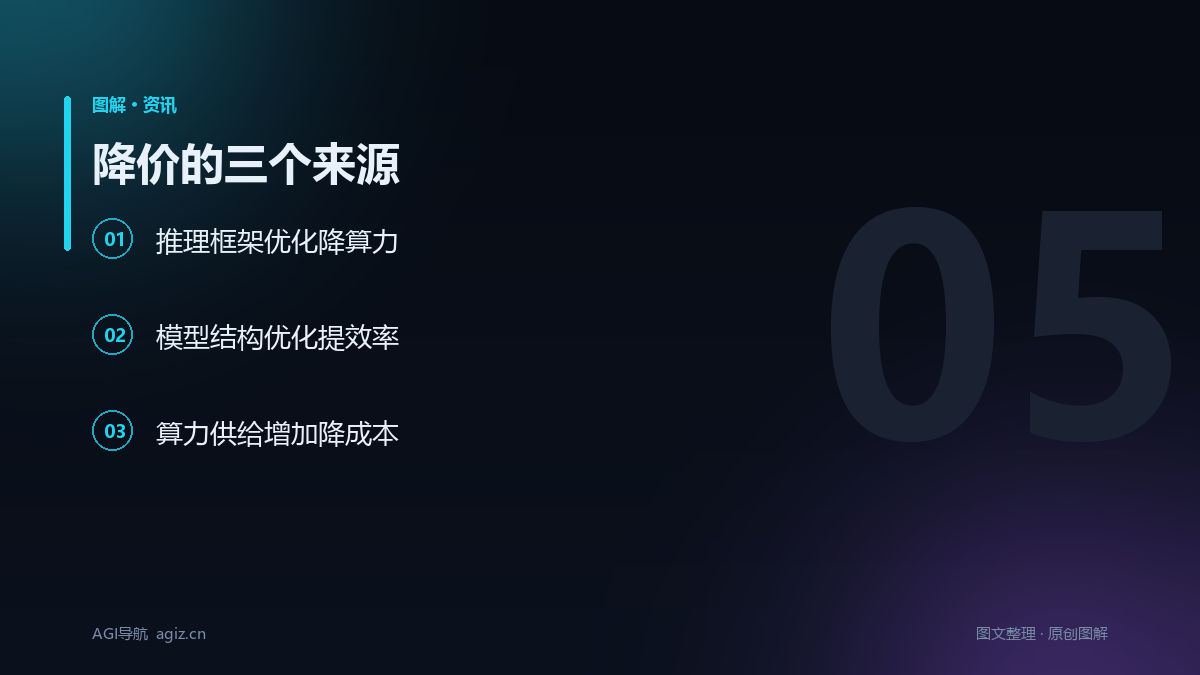
一是推理框架优化:批处理、KV 缓存复用、投机解码,把单位 token 的算力压下来;二是模型结构优化:更高效的注意力机制和稀疏激活;三是算力供给增加,单位 GPU 小时的价格在降。
对使用者的意义
以前「要不要开推理模式」是个成本问题,现在更多是效果问题。该开就开,不必为了省钱让模型硬答。
别忽略的隐性成本
推理模型输出更长,同样的任务消耗的 token 更多。按 token 计费时,单价降了但总量涨了,实际支出未必同比例下降。
一个观察
价格战最终会停在「够用就好」的水平。真正的差异会回到效果、稳定性和工具链,而不是每百万 token 差几毛钱。