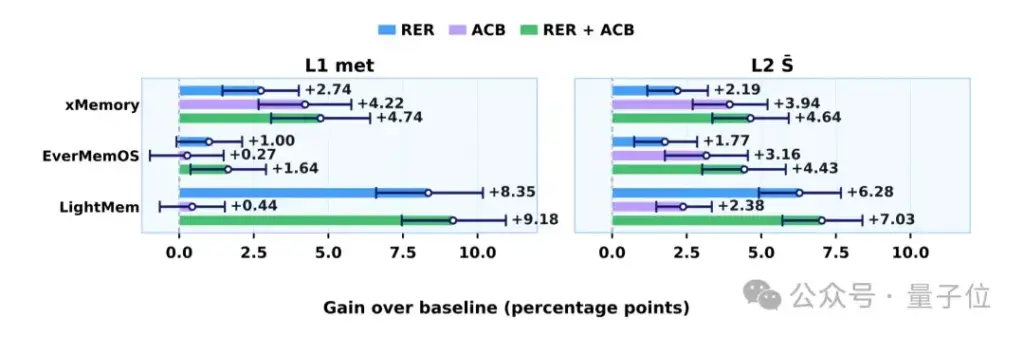
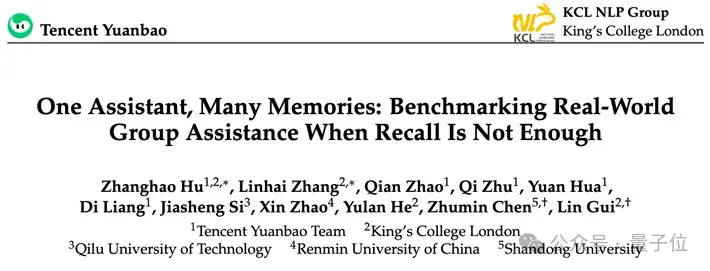
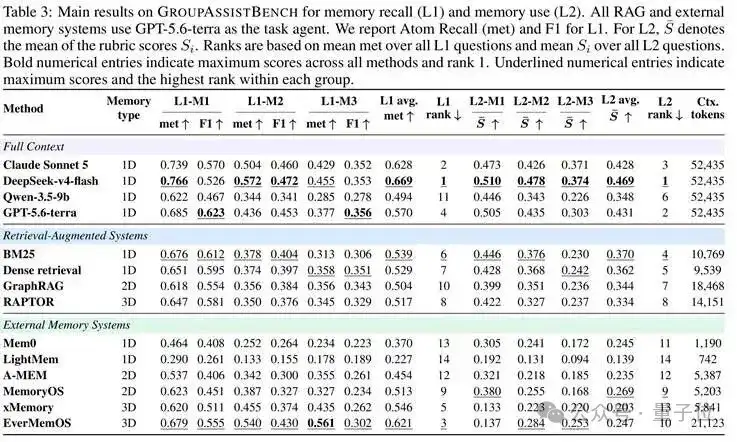
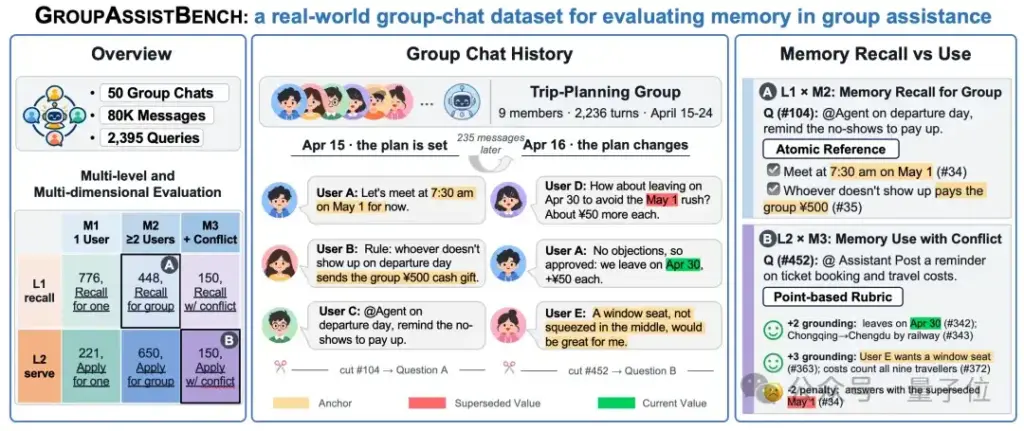
腾讯元宝与伦敦国王学院(KCL)联合发布了一个面向Agent记忆能力的评测基准,其特殊之处在于语料来源:不是单人对话或文档问答,而是真实的群聊。据量子位报道,该基准由8万条群聊消息构建成“考卷”,用于检验智能体能否在多人、多话题交织的对话流中记住并正确调用信息。这也是首个基于群聊构建的Agent记忆基准。
为什么群聊是记忆评测的硬骨头
现有Agent记忆评测多集中在单用户长对话或文档检索,信息归属清晰、话题线单一。群聊则不同:多个说话人交替发言,同一句话的指代对象随上下文漂移,话题可能被中途打断后再被拉回,还有大量寒暄、表情与无关内容构成噪声。要在这种场景里答对问题,Agent不仅要“存得住”,还要判断哪条信息属于谁、发生在什么语境下。群聊因此成为检验记忆检索与消歧能力的天然压力测试场。
基准设计透露的评测取向
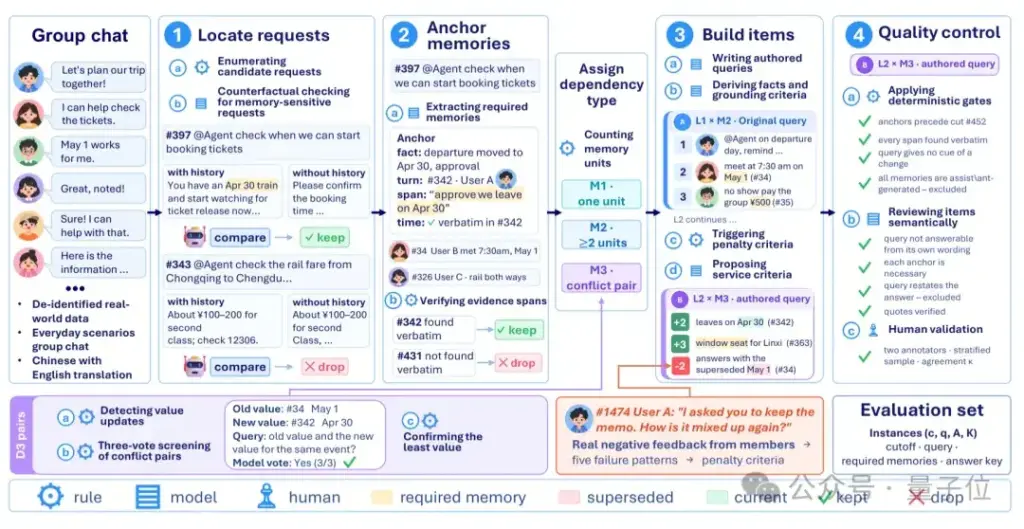
从公开信息看,该基准以群聊消息为原料生成考题,意味着评测重点从“能否复述原文”转向“能否在噪声中定位并推理”。这类题目通常要求模型跨越时间跨度关联多条消息,或识别同一用户在不同话题下的表态变化。对行业而言,这补上了记忆评测中长期缺失的一块:真实社交场景下的多人上下文。此前不少记忆方案在单线程对话中表现良好,一旦进入群聊环境便容易出现张冠李戴或信息遗漏,该基准提供了可比较的标尺。
对Agent产品落地的现实意义
群聊是国内用户最高频的沟通形态之一,微信、QQ、企业协作工具中沉淀了大量协作信息。Agent若要真正进入这些场景,替用户总结群内讨论、追踪待办、回答“上次谁提过这个方案”,记忆能力必须经得起多人对话的考验。腾讯元宝参与构建该基准,也与其在社交与办公场景的产品方向相呼应。基准本身不直接等于产品能力,但它把“群聊记忆”从模糊体验变成了可量化指标,为后续模型迭代提供了参照。
对国内用户来说,这项基准的价值不在于榜单分数,而在于它把群聊这一最日常也最复杂的场景纳入Agent能力评价体系,未来群聊助手的可靠性有望因此变得可衡量。
来源:量子位 查看原文 (本文基于公开信息整理改编)