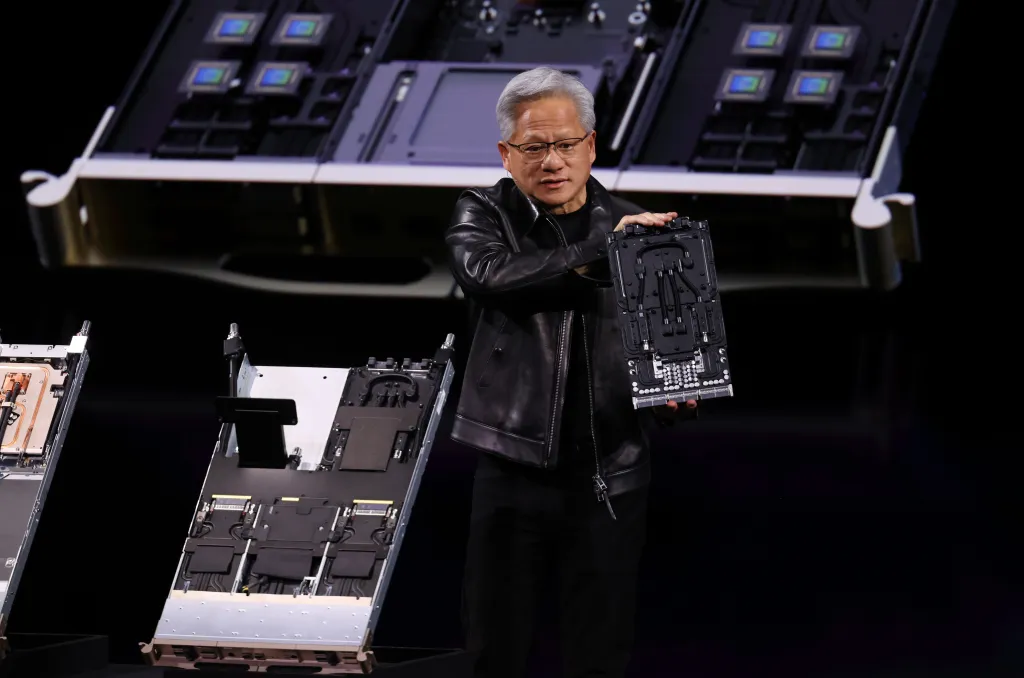
TechCrunch 报道了一项新研究:中国目前能力最强的一批人工智能模型,训练过程依赖的是处于美国出口禁令范围内的英伟达芯片。报道以调侃黄仁勋的语气点出这一反差——管制清单上的硬件,恰恰支撑了被管制的对象最前沿的成果。原文未披露研究机构、具体芯片型号与模型名单。
管制逻辑与执行现实之间的缝隙
美国对高端英伟达芯片的对华出口限制,核心假设是算力代差可以转化为模型代差。这项研究的意义不在于证明某款芯片“流出”,而在于提示:训练一个顶级模型所需的算力,未必需要管制方设想的那种最新一代硬件。存量设备、灰色渠道、第三方转口以及租赁算力,都可能让纸面上的禁令与实际可获得的算力脱节。对政策制定者而言,这构成一个执行层面的难题——管制清单越细,规避路径往往也越分散。
对国产算力叙事的一次外部注脚
国内舆论长期把国产芯片替代视为确定方向,但这项研究提醒,头部模型的训练成绩单里仍有相当部分来自英伟达生态。这既说明国产算力在软件栈、互联带宽和稳定性上仍有差距,也说明在过渡期内,谁能稳定获得并可高效调度既有算力,谁就能维持模型迭代节奏。把这一发现简单读成“禁令失效”或“国产不行”都不准确,它更像是一张现实的能力分布图。
接下来值得观察的三个变量
一是研究本身能否公开更多方法细节,让外界判断结论的适用范围;二是美国监管方是否会据此调整管制口径,从管芯片转向管算力获取渠道;三是国内厂商在推理与训练环节的国产化比例是否会在下一轮模型发布中体现出来。对开发者来说,短期更实际的问题是算力成本与可获得性,而非芯片国籍本身。
对国内用户而言,这项研究的直接含义是:头部模型的可用性与迭代速度,短期内仍受制于算力供给的实际格局,而非单纯的禁令文本。
来源:TechCrunch AI 查看原文 (本文基于公开信息整理改编)