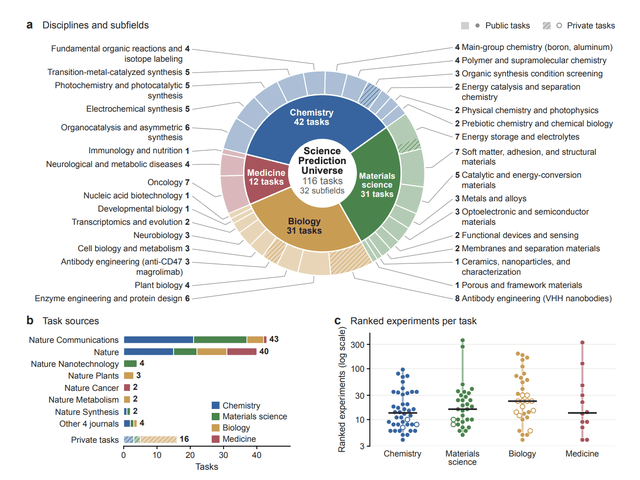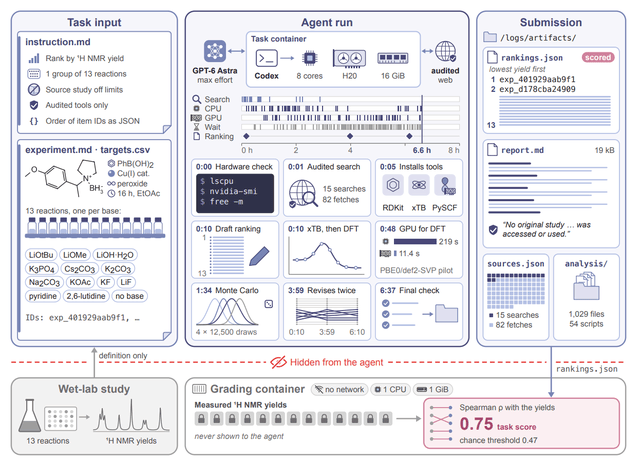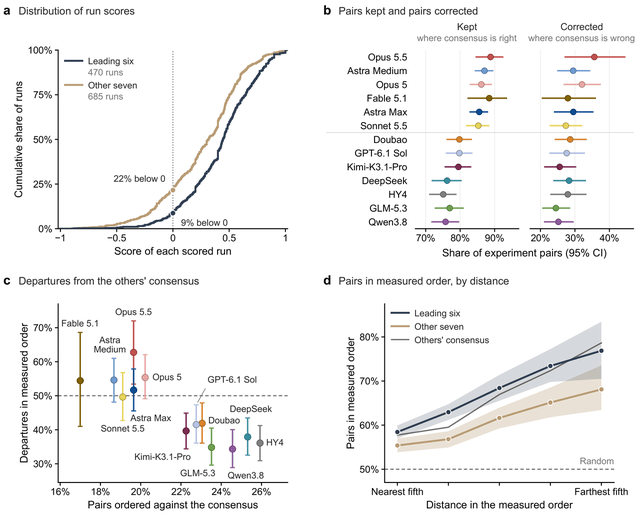
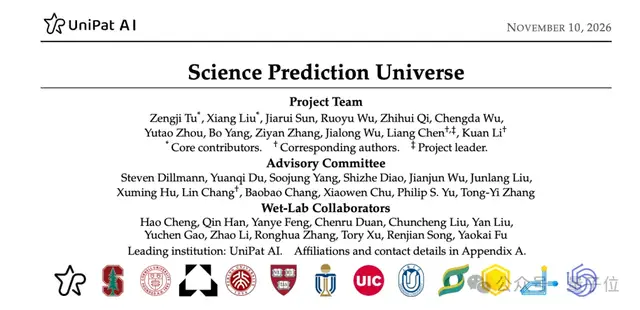
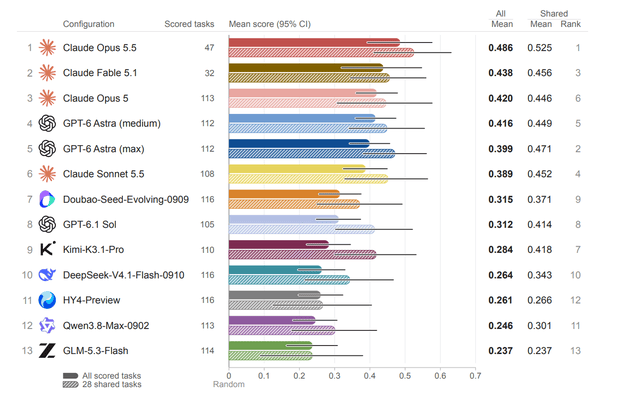
量子位报道,斯坦福、哈佛、康奈尔等十余家顶尖团队联合发布了一个被形容为“史上最严”的湿实验预测基准。该基准面向的是让模型预测真实湿实验结果的 task:在推理能力拉满、算力投入翻五倍的条件下,成绩依然没有出现预期中的突破。这一结果直接指向当前 AI for Science 评测中的一个敏感问题——模型在纸面题目上的高分,未必能转化为对真实实验结果的可靠预判。
为什么“湿实验预测”难被攻破
湿实验涉及试剂、细胞、动物模型与操作条件,结果受大量未写入论文的隐性变量影响。与结构化的考试题不同,湿实验预测要求模型在信息不完整、噪声显著的前提下给出可验证的判断,这使单纯扩大参数与算力难以奏效。该基准由多机构共同设计,意味着题目与评价口径经过交叉审核,降低了单一团队“自出题、自打分”带来的乐观偏差,也让此前一些亮眼成绩面临更严格的复核。
算力翻五倍仍无突破说明什么
报道提到,即便把推理拉满、算力提高到原来的五倍,结果依旧不理想。这提示在湿实验预测这类任务上,瓶颈可能不在模型规模,而在数据质量、实验表征方式与领域知识的注入方式。对 AI for Science 而言,这意味着“堆算力换性能”的路径需要被重新审视:如何把实验条件、阴性结果与操作细节转化为可学习信号,可能比继续扩大训练规模更关键。
对评测生态的影响
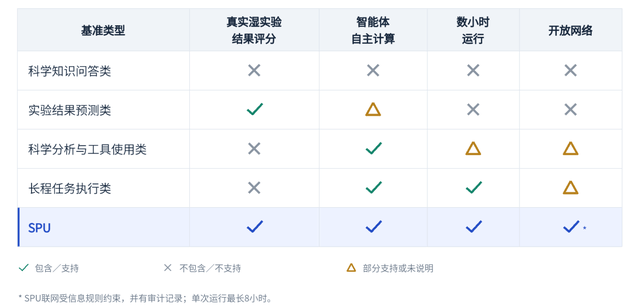
一个由十余家机构共建的严苛基准,往往会成为后续研究的参照系。它一方面会压低虚高的榜单分数,另一方面也会迫使团队把精力从刷分转向可复现的实验设计。对产业界而言,这类基准的价值在于给出更接近真实研发场景的能力刻度,帮助判断模型在药物发现、材料筛选等环节究竟能承担多少决策权重,而不是仅凭演示效果做投入判断。
对国内用户来说,这一基准提醒:评估 AI for Science 产品时应关注其在独立湿实验数据上的表现,而非厂商自报的榜单成绩。
来源:量子位 查看原文 (本文基于公开信息整理改编)