图生视频:把关键静帧直接喂给模型
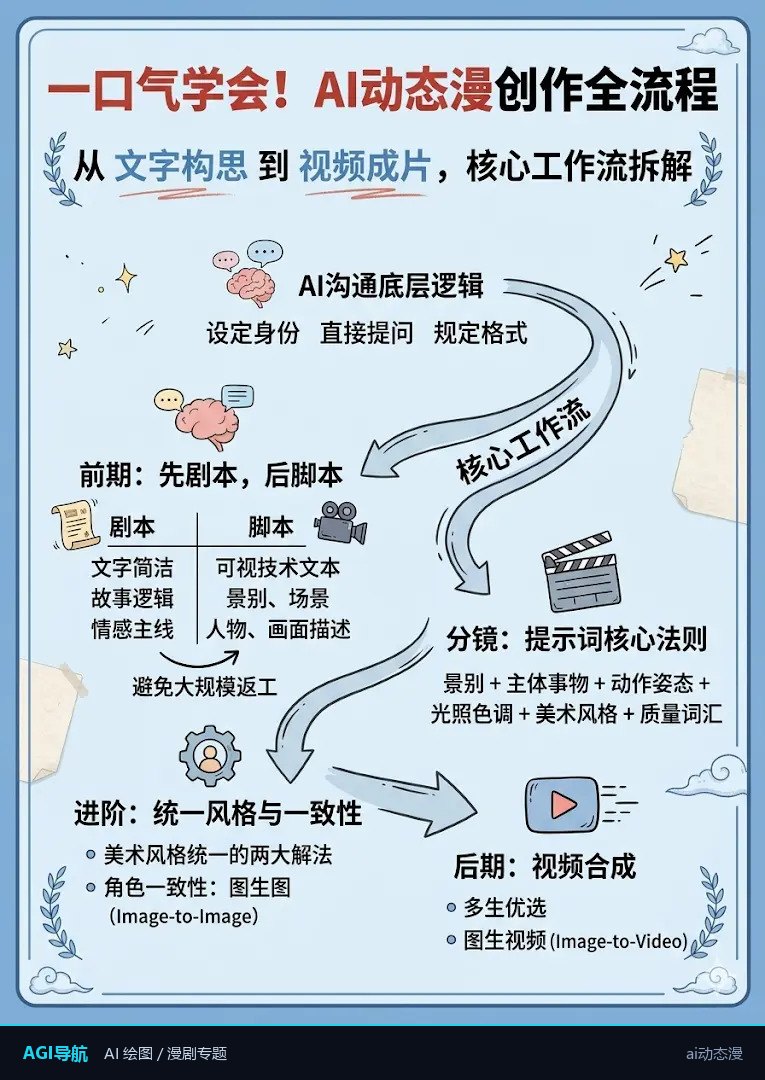
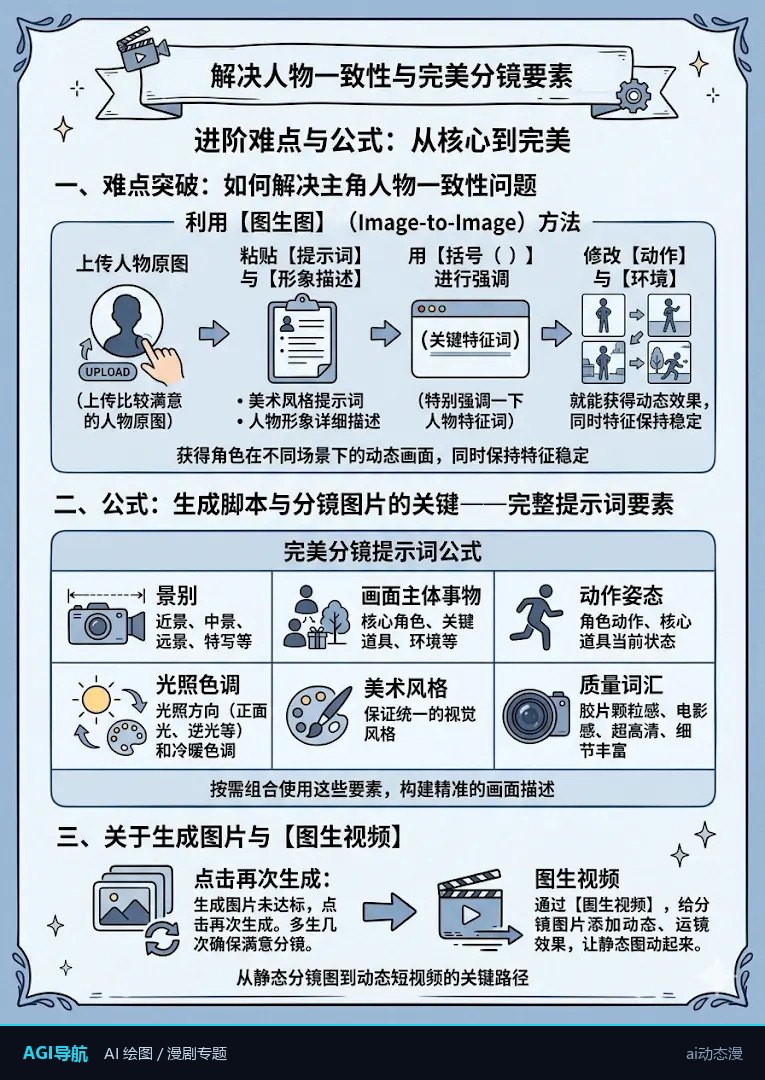
做法很直接:先在 Midjourney 或即梦出好一张构图完整的静帧,分辨率不低于 1280×720,人物占画面 1/3 以上,再上传到可灵、Vidu 或 Runway 的图生视频入口。提示词只写运动,不写画面内容,例如“镜头缓慢推近,人物轻微呼吸,发丝飘动”,时长设 5 秒,运动幅度调到中低档。适合动的镜头是:人物站立说话、风吹衣角、背景云层流动、镜头推拉。这类画面主体清晰、层次简单,模型不容易乱改结构。一动就崩的镜头包括:多人同框、手部特写、快速转身、复杂透视的室内场景,模型会在 3 秒后开始融化五官或让手指增殖。经验数字:单张图生成 5 秒片段,抽 3 次挑 1 条可用,废片率约 60%。
首尾帧:用两张图锁住起止动作
首尾帧适合有明确起止状态的镜头,比如人物从低头到抬头、从门口走到桌前、从闭眼到睁眼。做法是同一角色、同一场景出两张图,构图和光线保持一致,只改动作状态,然后分别作为首帧和尾帧输入,中间帧交给模型补。可灵和 Vidu 都支持这个模式,时长设 4 到 6 秒最稳,超过 8 秒中间段容易糊。关键数字:两张图的角色面部位置偏差控制在 5% 以内,否则模型会做出“换脸”式过渡。适合的首尾帧镜头是单人、半身、背景虚化;不适合的是全景大调度和多人互动,因为中间帧没有约束,模型会自由发挥。口型不要靠首尾帧做,它只解决身体动作。
局部动效:只让该动的地方动
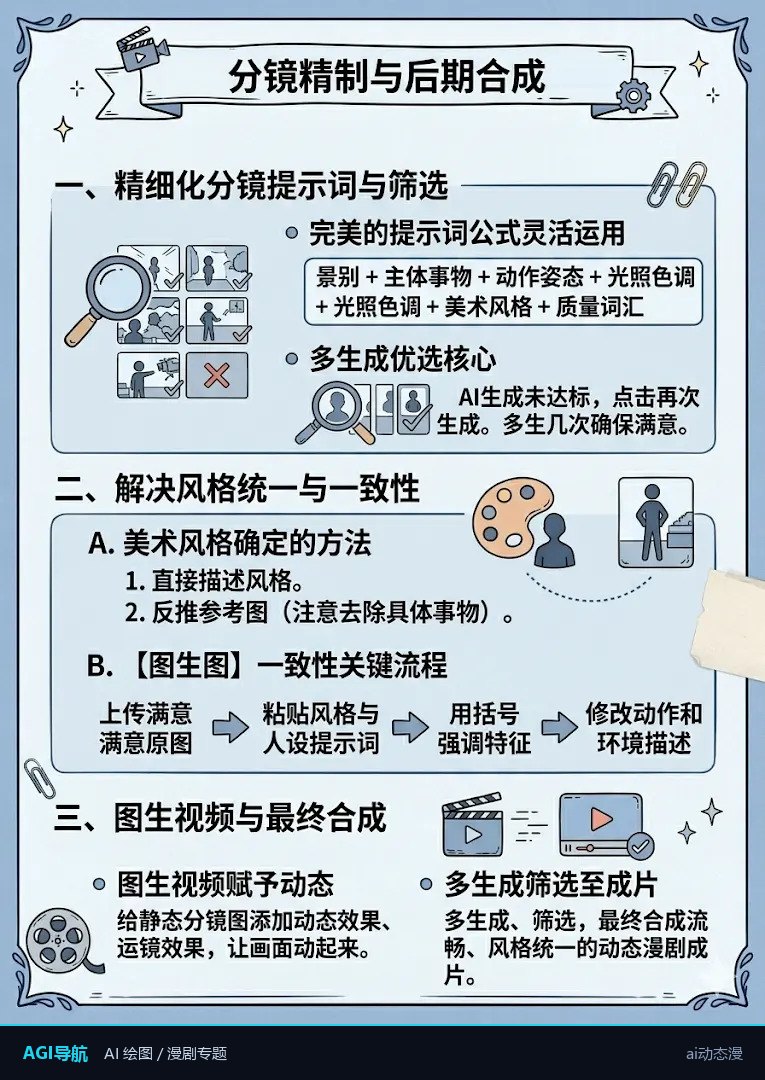
局部动效是动态漫最稳的一条路。做法是把静帧拆层:人物、前景、背景各一层,用剪映或 AE 给背景加缓慢平移,给人物加 2 到 4 像素的上下浮动,给眼睛和嘴单独做循环。眼睛每 3 秒眨一次,眨眼用两张图交替,每张停留 0.1 秒。口型按台词音节切,一句 5 字的话配 5 个口型帧,每帧 0.12 到 0.15 秒,只做张嘴、半张、闭合三种状态就够用。表情变化用 2 到 3 张关键表情图交叉淡化,淡化时长 0.3 秒。这条路线崩的概率最低,因为画面结构没交给模型重算。适合所有对话镜头和特写,缺点是动作幅度小,不能做打斗和奔跑。
成本对比:动态漫和真视频差多少
按 1 分钟成片算。动态漫:静帧 20 到 30 张,每张出图成本约 0.3 到 1 元;图生视频片段约 15 条,每条 5 秒,按可灵标准档约 3 到 5 元一条,合计 50 到 80 元;局部动效不额外花钱,只花剪辑时间。总现金成本 100 元以内,人工 1 到 2 天。真视频:实拍 1 分钟至少半天场地加 2 名演员,成本 2000 元起;纯 AI 真视频要 60 条 5 秒片段,按高质量档 10 元一条算 600 元,废片重抽翻倍到 1200 元,人工 3 到 5 天。差距主要在废片率和重抽次数:动态漫靠局部动效把废片率压到 20% 以下,真视频路线废片率常在 50% 以上。