剧本拆解与分镜:把文字变成可执行的镜头清单
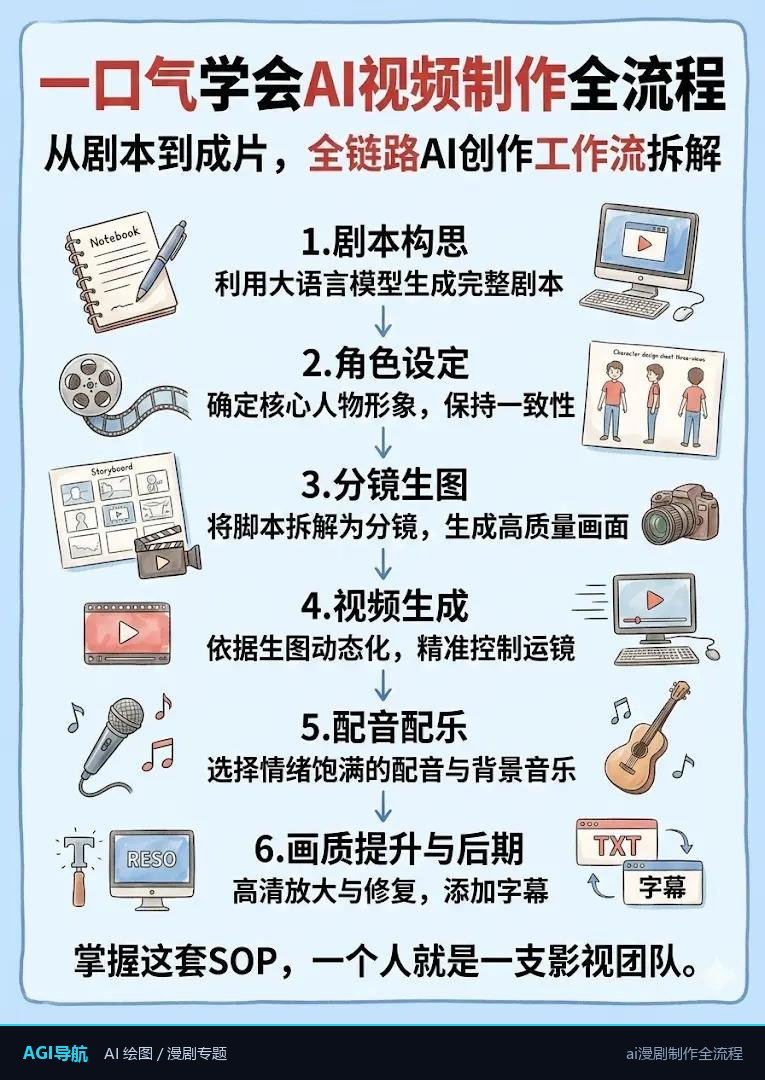
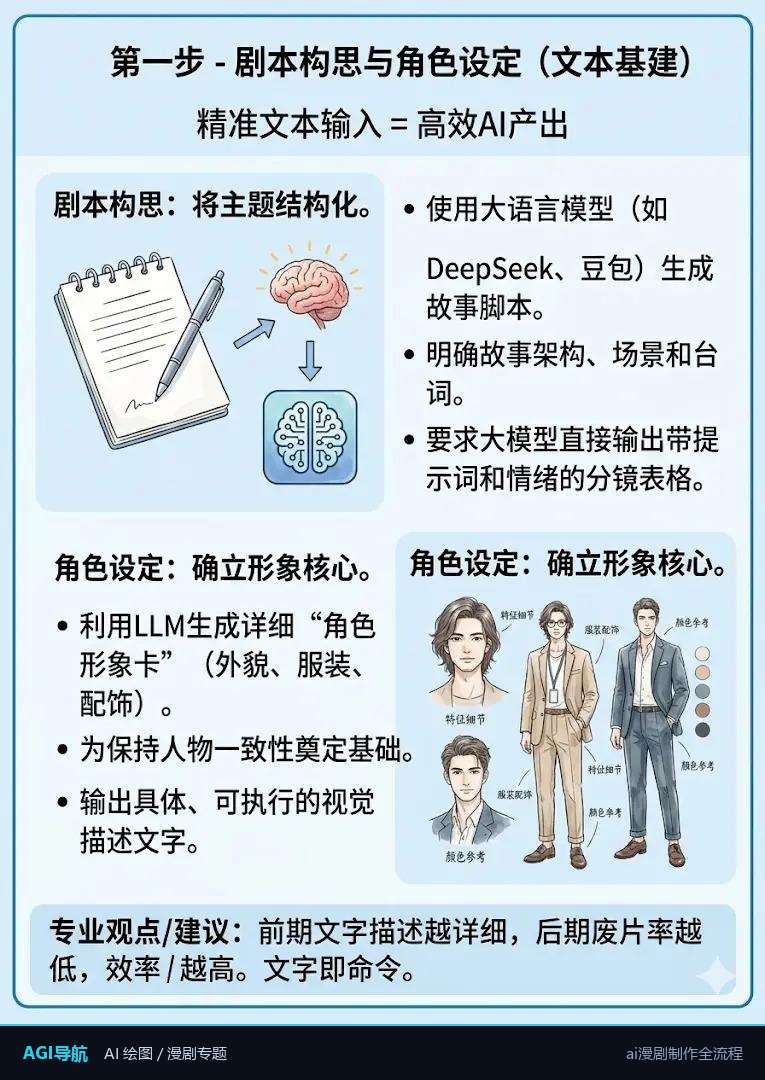
先写 800 到 1200 字剧本,控制在 3 分钟成片、约 450 到 550 字台词。用 DeepSeek 或 Claude 把剧本拆成镜头表,提示词写死格式:镜号、场景、景别、角色动作、台词、时长。一部三分钟短剧通常 35 到 50 个镜头,单镜 3 到 6 秒。产出物是一张 CSV 分镜表,后面所有环节都读它。分镜阶段就要标出哪些镜头是空镜、哪些是对话正反打,空镜和正反打最适合批处理。角色设定单独建一份文档,写清发型、服装、配色三行关键词,后面生成图像时原样复用,避免角色漂移。这一步一个人 2 到 3 小时能完成,别在这一步反复改台词,改一次后面全要重跑。
图像生成与角色一致性:先定妆再批量出图
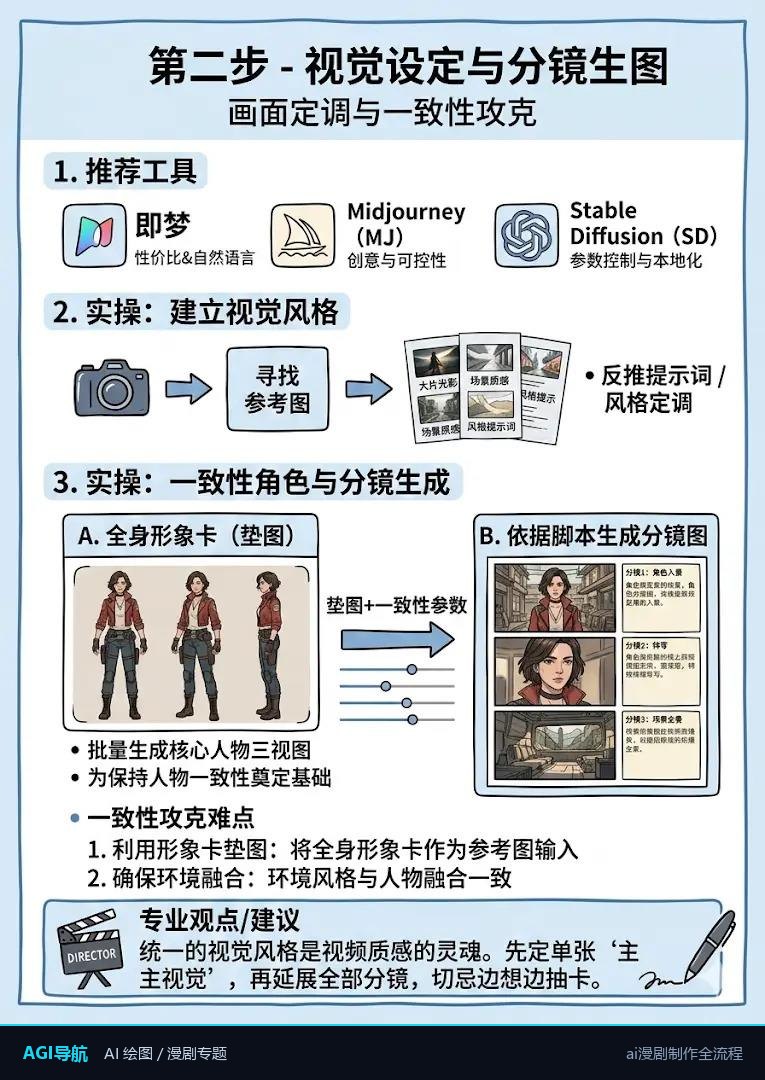
用即梦或 Midjourney 先出 3 到 5 张角色定妆图,选定一张后作为参考图,后续所有镜头都带参考图生成,权重设 0.6 到 0.8。分镜表里每个镜头生成 2 张备选,50 个镜头就是 100 张,按场景分组批量跑,一组 10 到 15 张,单张出图 20 到 40 秒。产出物是按镜号命名的 PNG 文件夹,命名规则统一为 S01_001.png。背景和空镜不需要参考图,可以整批丢进去跑。人物近景必须逐张检查手部和五官,废片率通常 20% 到 30%,预留重跑时间。这一步一个人 3 到 4 小时,其中一半时间在筛图。筛完统一裁成 16:9 或 9:16,分辨率 1080p。
图生视频与配音:最耗时的批处理环节
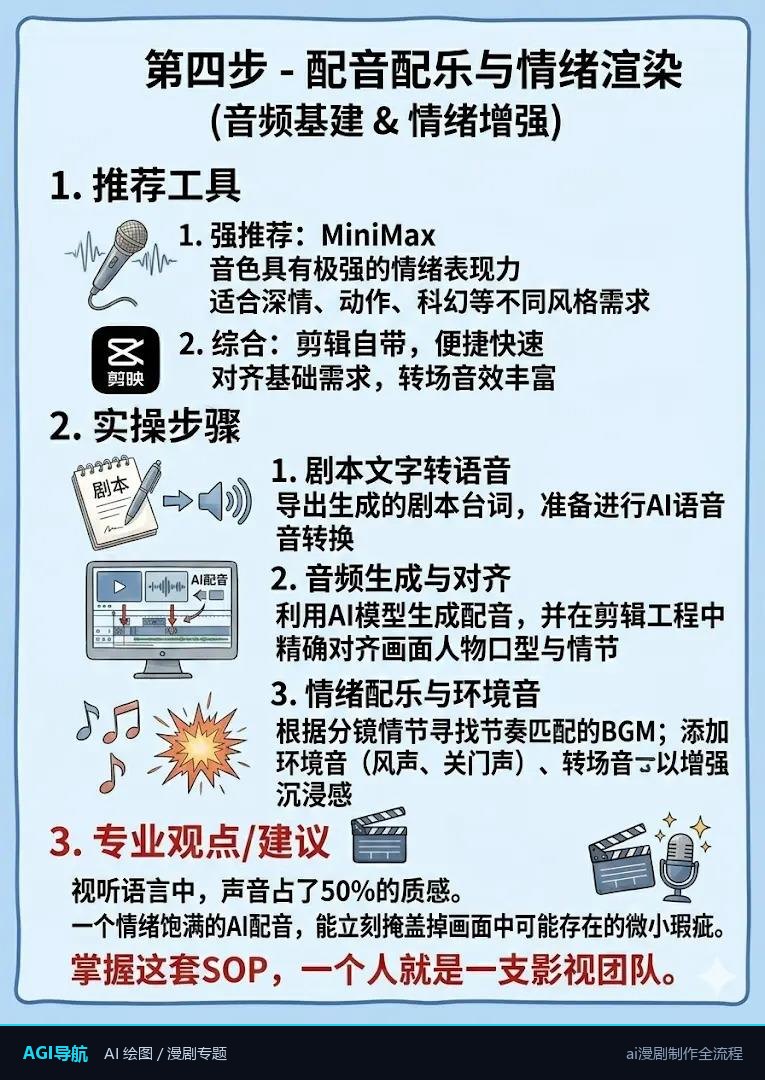
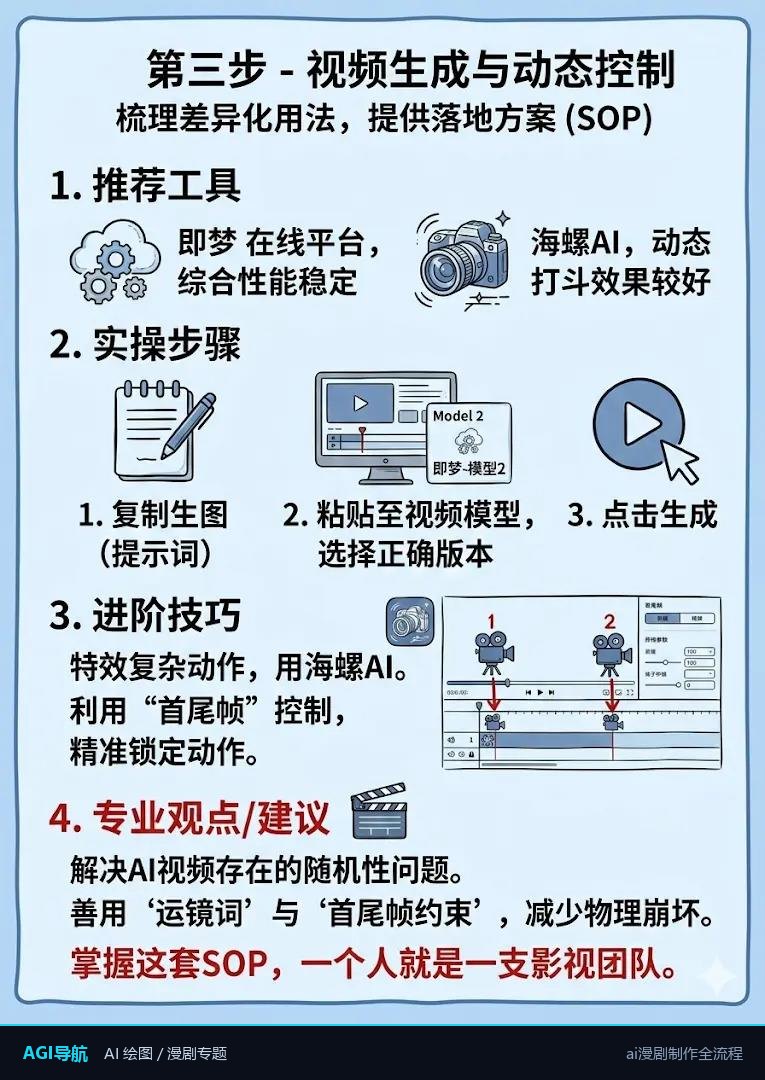
用可灵或 Runway 做图生视频,单镜 3 到 5 秒,提示词只写运动方式,比如“镜头缓慢推近,人物眨眼,头发轻微飘动”,别写剧情。每条生成 1 到 2 次,单条 1 到 3 分钟,50 个镜头约 2 到 3 小时,这是全流程最耗时的一步,可以整批排队后去写下一集剧本。产出物是每镜一段 MP4。配音用剪映或 ElevenLabs,按分镜表台词逐条生成,一个角色一个音色,导出 48kHz WAV。口型对不上就缩短单镜时长或加一句旁白遮过去。音效和环境音从素材库按场景批量下载,每集准备 10 到 15 条。这一步一个人 4 到 5 小时,其中视频生成可以完全无人值守。
剪辑合成与一人时间表:把流水线跑顺
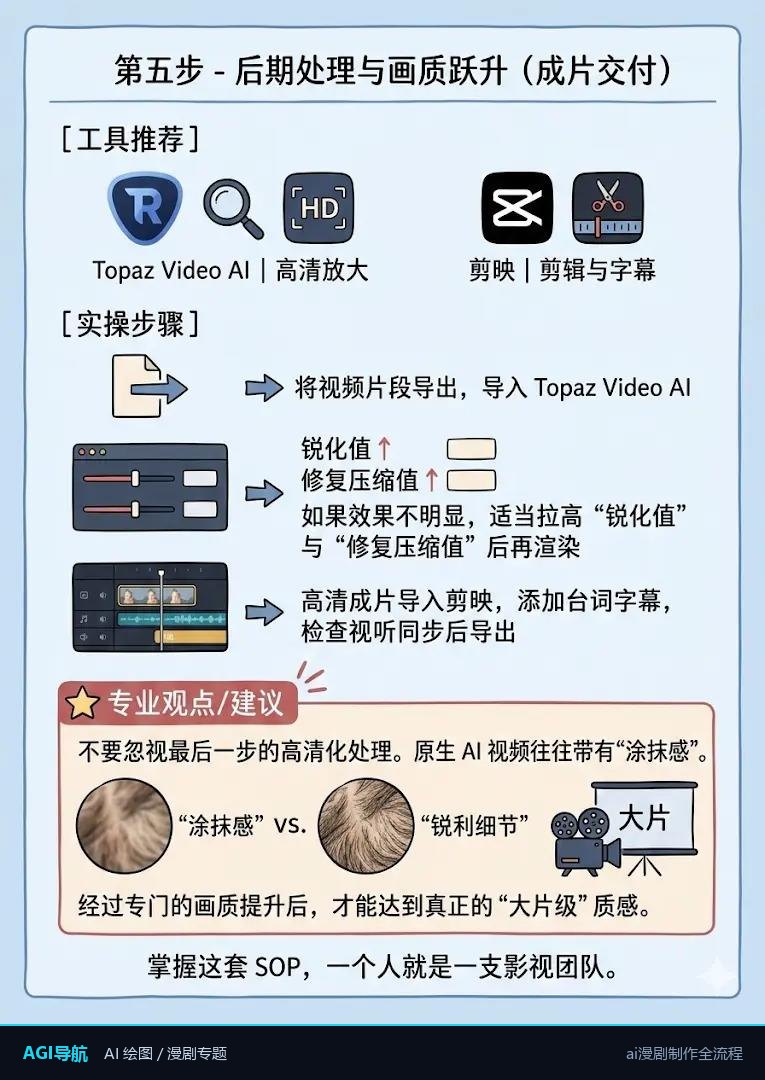
剪映里按分镜表顺序铺素材,单镜对齐配音,转场只用硬切和叠化两种,加字幕用自动识别再逐条校对。产出物是一条 3 分钟成片加一份工程文件。可批处理的环节是:图像生成、图生视频、配音、字幕识别、音效下载,这五项占总量约 70%,都能排队跑。一个人做一部三分钟短剧的实测时间表:剧本与分镜 3 小时,出图与筛图 4 小时,图生视频 3 小时(含排队),配音音效 2 小时,剪辑合成 3 小时,合计 15 小时左右,拆成两个工作日。第二部开始因为角色参考图和提示词模板已固化,能压到 10 到 12 小时。想再快,就把分镜表做成固定模板,每集只换内容不换结构。