全能参考机制:把图、文、音、视频塞进同一个提示词
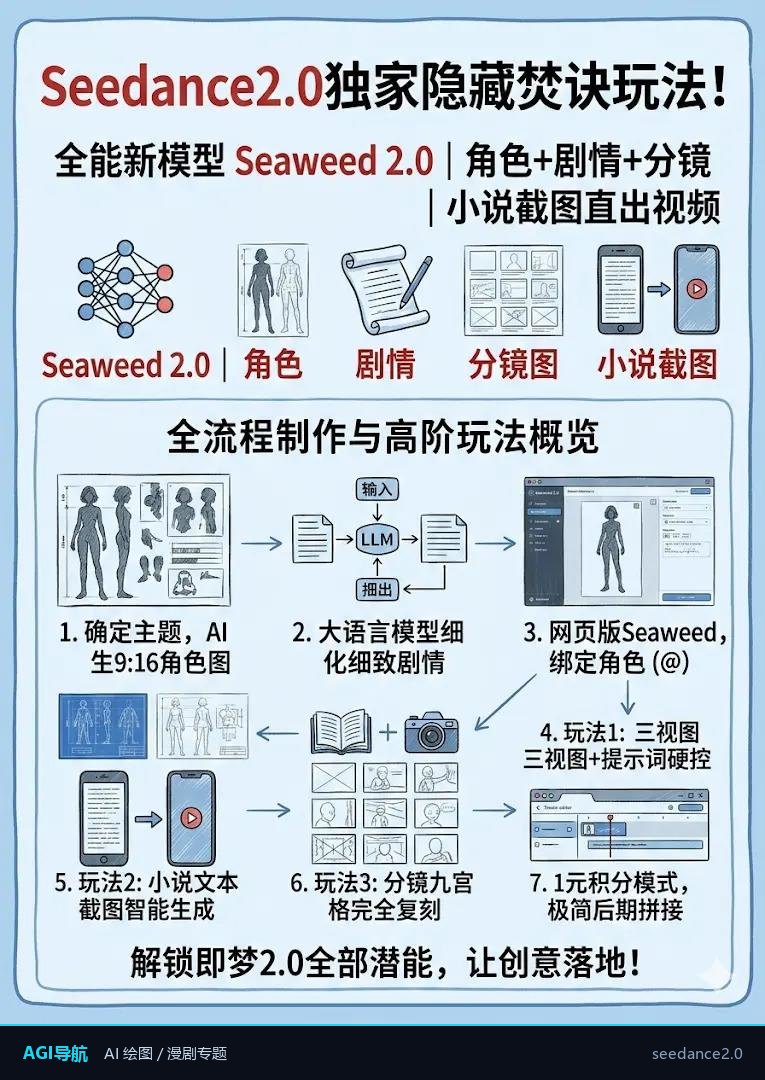
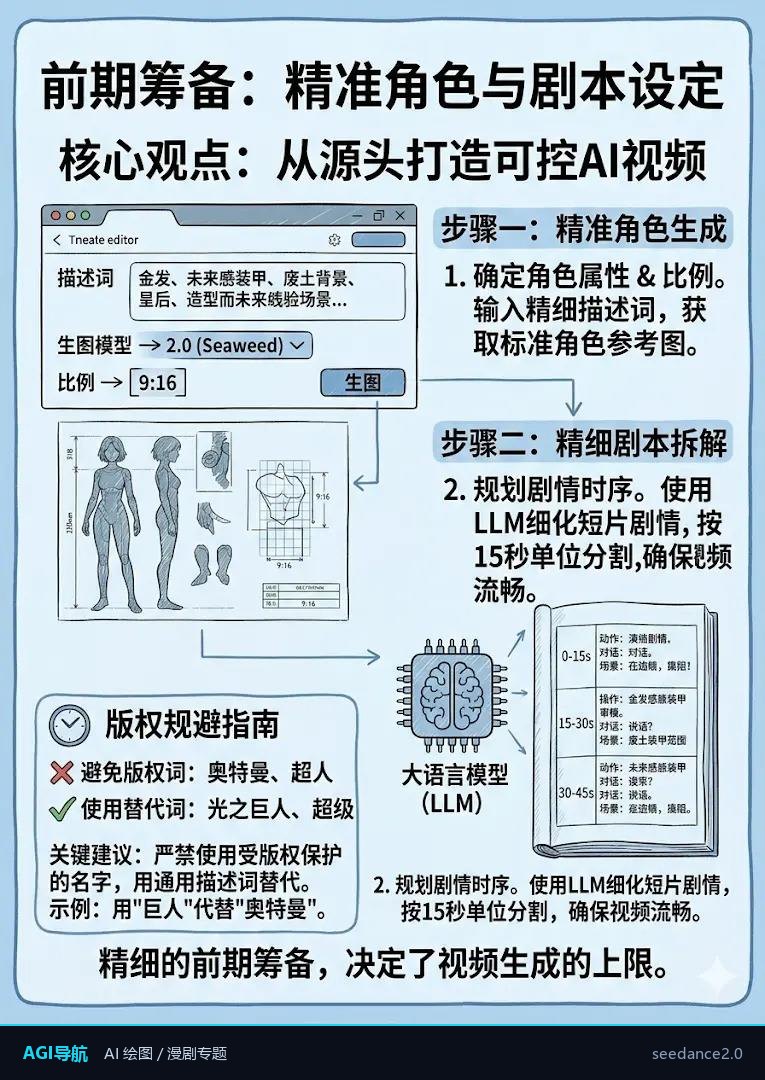
Seedance 2.0 的全能参考,本质是让模型在生成时同时读取多种模态的参考素材,而不是只靠一段文字描述。你可以在一次请求里挂上 1 张角色图、1 段 5 秒参考视频、1 段 3 秒音频和一段文字说明,模型会把它们对齐到同一个生成结果里。实操上,图片负责定角色和画风,视频负责定运镜和动作节奏,音频负责定口型与节拍,文字负责补场景和剧情。注意素材不是越多越好:单次参考建议控制在图片 1 到 2 张、视频 1 段、音频 1 段,超过这个量模型容易顾此失彼,出现角色漂移或动作错位。素材之间要一致,比如角色图是正面半身,参考视频就别用背影大全景,否则模型对齐时会打架。
@语法:在提示词里精确点名每个素材
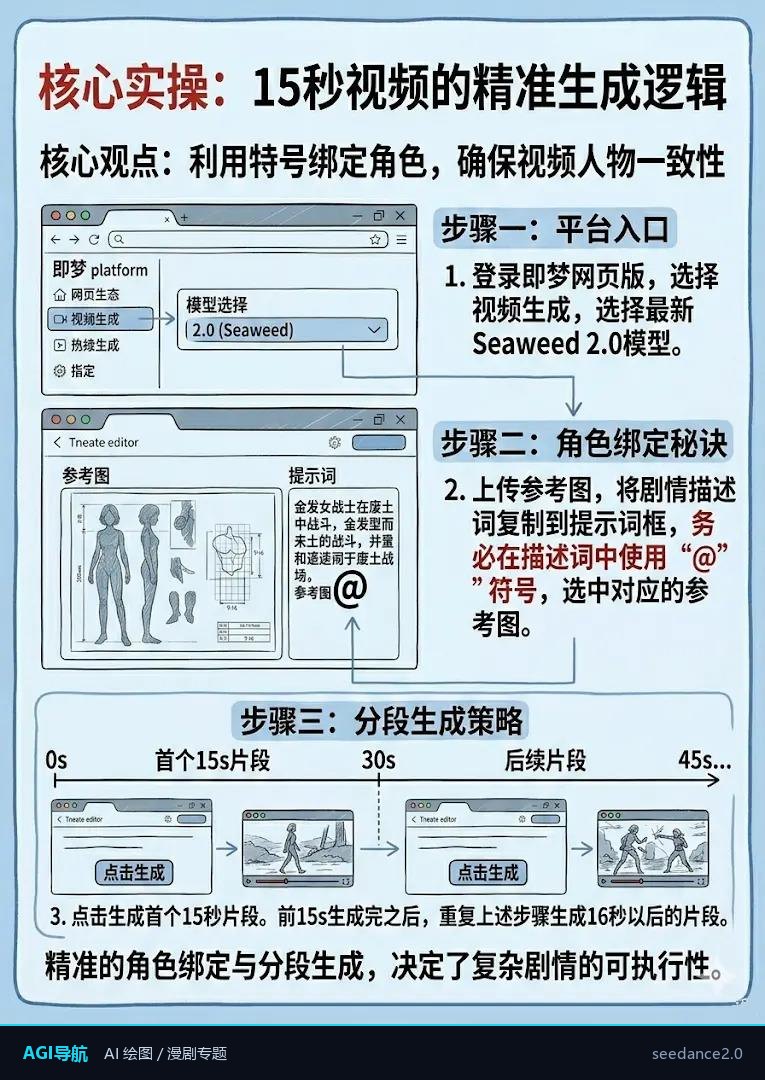
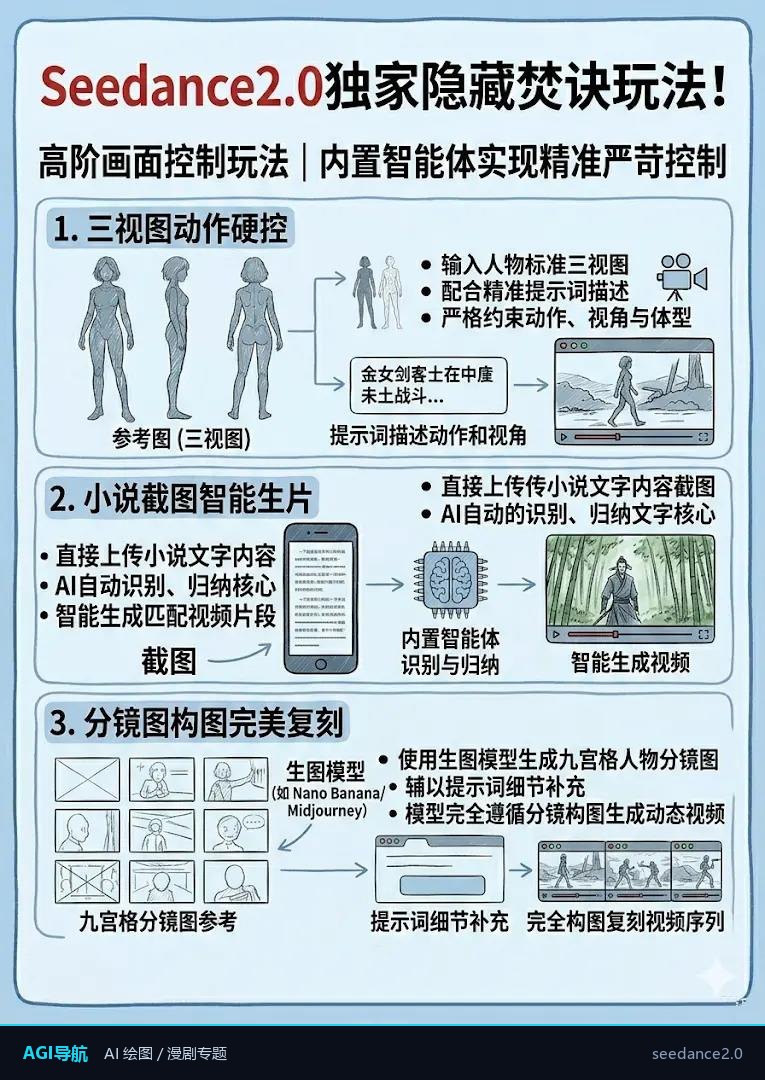
@语法用来把提示词里的某个词绑定到具体素材上,写法是 @素材名,素材名在上传时自己起,建议用英文短名,比如 @hero、@cam、@voice。示例:@hero 站在雨夜街头,镜头参考 @cam 的横移节奏,口型对齐 @voice。规则有三条:第一,@ 后面必须紧跟已上传的素材名,名字不能带空格;第二,同一个素材可以在提示词里多次引用,但每次都要写全 @ 名;第三,没被 @ 的素材仍会作为全局参考生效,所以不想让它干扰的素材就别上传。常见错误是把 @ 写在句尾当装饰,模型读不到绑定关系,正确做法是让 @ 名紧挨着它修饰的对象,比如“@hero 的外套”比“外套 @hero”更稳。
参考素材的准备顺序:先定人,再定动,最后定声
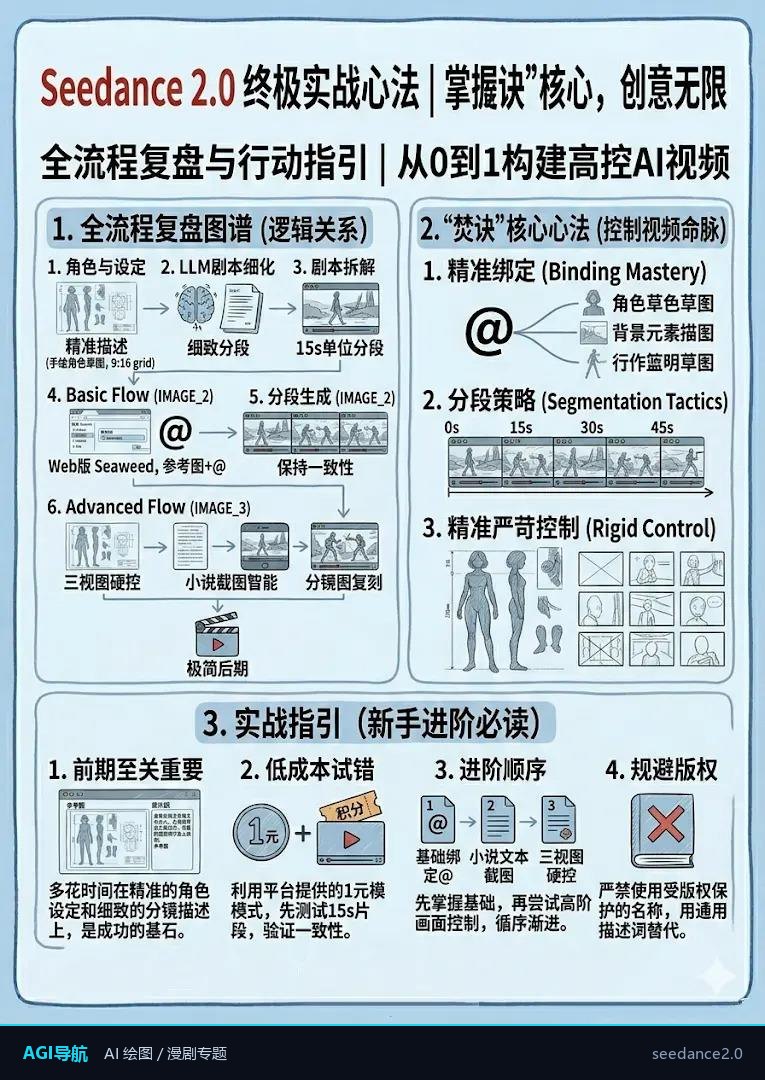
顺序错了会反复返工,按这个流程走:第一步准备角色图,选正面或 3/4 侧面、光线均匀、分辨率不低于 1024×1024 的图,背景尽量干净,这一步决定角色一致性。第二步准备参考视频,长度 3 到 8 秒,只保留你要的运镜或动作,剪掉多余转场,帧率统一到 24 或 30fps。第三步准备音频,取 3 到 10 秒清晰人声,去掉背景音乐和混响,采样率 44.1kHz。第四步写文字提示词,把场景、动作、镜头、@ 绑定一次写清。每步做完先单独跑一次短生成验证,比如只用角色图加文字出 2 秒片段,确认脸不崩再叠加视频和音频,避免四类素材一起上导致问题定位不了。
参数调节:时长、比例、运动强度的手感
时长按用途定:漫剧单镜头 3 到 5 秒最稳,超过 8 秒角色一致性明显下降,长镜头建议拆成多段再剪。比例跟随发布平台,竖屏漫剧用 9:16,横屏叙事用 16:9,方图 1:1 只适合头像或封面,改比例后要重新检查构图,人物别贴边。运动强度分三档理解:低档 0.2 到 0.3 适合对话和特写,画面稳、口型准;中档 0.4 到 0.6 适合走位和转身;高档 0.7 以上只给打斗和快速运镜,且必须配参考视频,否则容易糊。调参顺序是先固定比例和时长,再从中档运动强度试起,每次只动一个参数,出片对比后再微调,别一次改三个。