本地部署的意义有三个:断网可用、数据不出本机、不用按次付费。代价是要有足够的硬盘和内存。
先看你的机器够不够
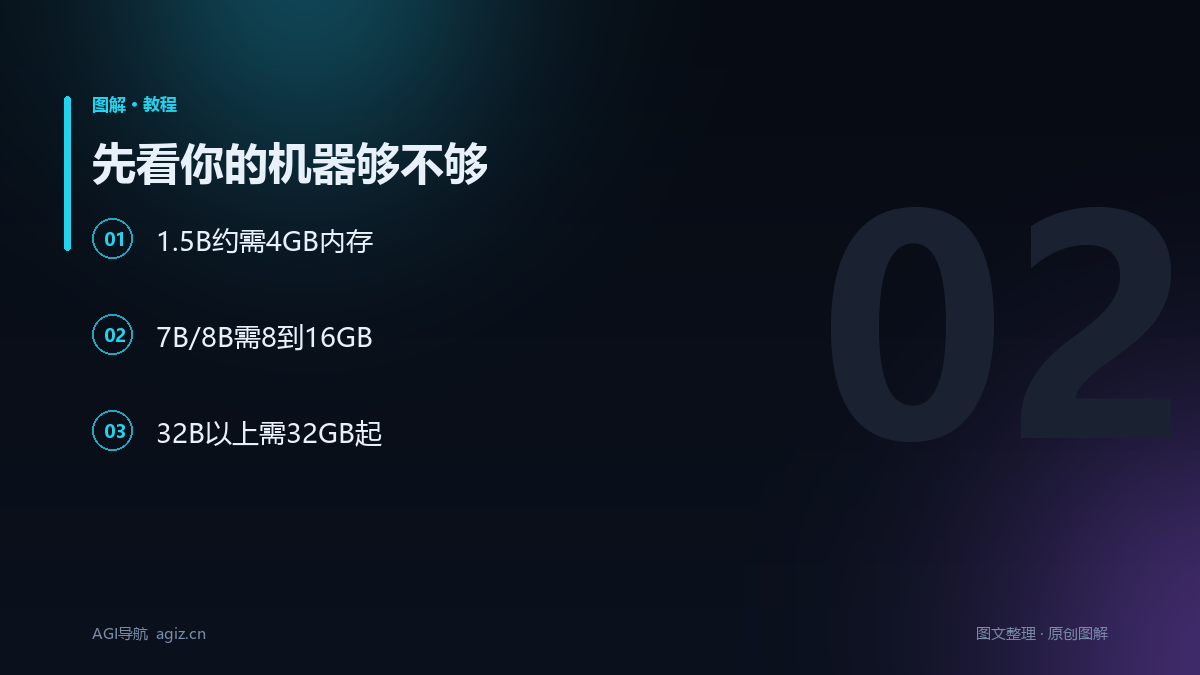
| 模型规模 | 大致内存需求 | 适合场景 |
|---|---|---|
| 1.5B | 4GB 左右 | 轻量问答、摘要 |
| 7B / 8B | 8–16GB | 日常写作、翻译 |
| 14B | 16–24GB | 较复杂的推理 |
| 32B 以上 | 32GB 起 | 接近在线版体验 |
没有独显也能跑,只是慢。7B 模型在普通笔记本上大约每秒几个字,够用来改稿,不适合长文生成。
安装 Ollama
官网下载对应系统的安装包,一路下一步即可。装完打开终端验证:
ollama --version拉取并运行模型
ollama run deepseek-r1:7b第一次会自动下载几个 GB,耐心等。下载完成后会直接进入对话界面,输入问题即可。
想换更小的:ollama run deepseek-r1:1.5b;想更好一点:ollama run deepseek-r1:14b。
接到图形界面
命令行不好用,可以接 Chatbox、Open WebUI 这类客户端。配置里填:
- API 地址:
http://127.0.0.1:11434 - 模型名:
deepseek-r1:7b
这样就有了一个完全离线的对话框。
几个实际经验
- 模型文件存在用户目录,占空间大,C 盘紧张时改到其他盘
- 首次加载慢,之后会缓存,第二次快很多
- 本地小模型的常识和长文能力明显弱于在线版,别指望它写完整报告
- 笔记本长时间跑会烫,注意散热
什么时候值得本地跑
处理不能外传的材料(合同、病历、内部文档),或者经常在没网的环境工作。其他情况,在线版更省事。